AI인프라혁신연구센터 - 한양인공지능특성화연구원(HY-IAA)
AI 혁신의 기반, 인프라에서 완성됩니다.
AI인프라혁신연구센터는 대규모 인공지능 모델의 학습과 추론을 효율적으로 지원하기 위한 차세대 컴퓨팅 시스템 및 AI 시스템 소프트웨어 기술을 연구합니다.
본 센터는 분산학습, 고성능 컴퓨팅, AI 시스템 최적화, 모델 서빙 및 운영 기술을 포함한 AI 인프라 전반을 아우르는 연구를 수행하며, 실제 산업 및 연구 환경에서 활용 가능한 고효율 AI 컴퓨팅 플랫폼 구축을 추진하고 있습니다. 또한 공동 활용 가능한 AI 컴퓨팅 환경을 통해 학내외 연구 생태계의 생산성을 높이고 있습니다.
AI 인프라혁신 연구센터는 초거대 AI 시대를 뒷받침하는 핵심 기반 기술 거점으로 도약하고 있습니다.
강수용 교수
AI인프라혁신연구센터장
약력
- 2003–현재 | 한양대학교 교수
- 2002–2003 | 서울대학교 컴퓨터공학부 박사후연구원
- 2002 | 서울대학교 컴퓨터공학과 박사
- 1998 | 서울대학교 컴퓨터공학과 석사
- 1996 | 서울대학교 수학과 학사
연구분야
- 클라우드 컴퓨팅, 모바일 플랫폼, IoT 플랫폼, Edge 컴퓨팅
센터 주요 연구주제
1. 이기종 GPU 및 다양한 가속기를 활용한 최적의 LLM 시스템 구성
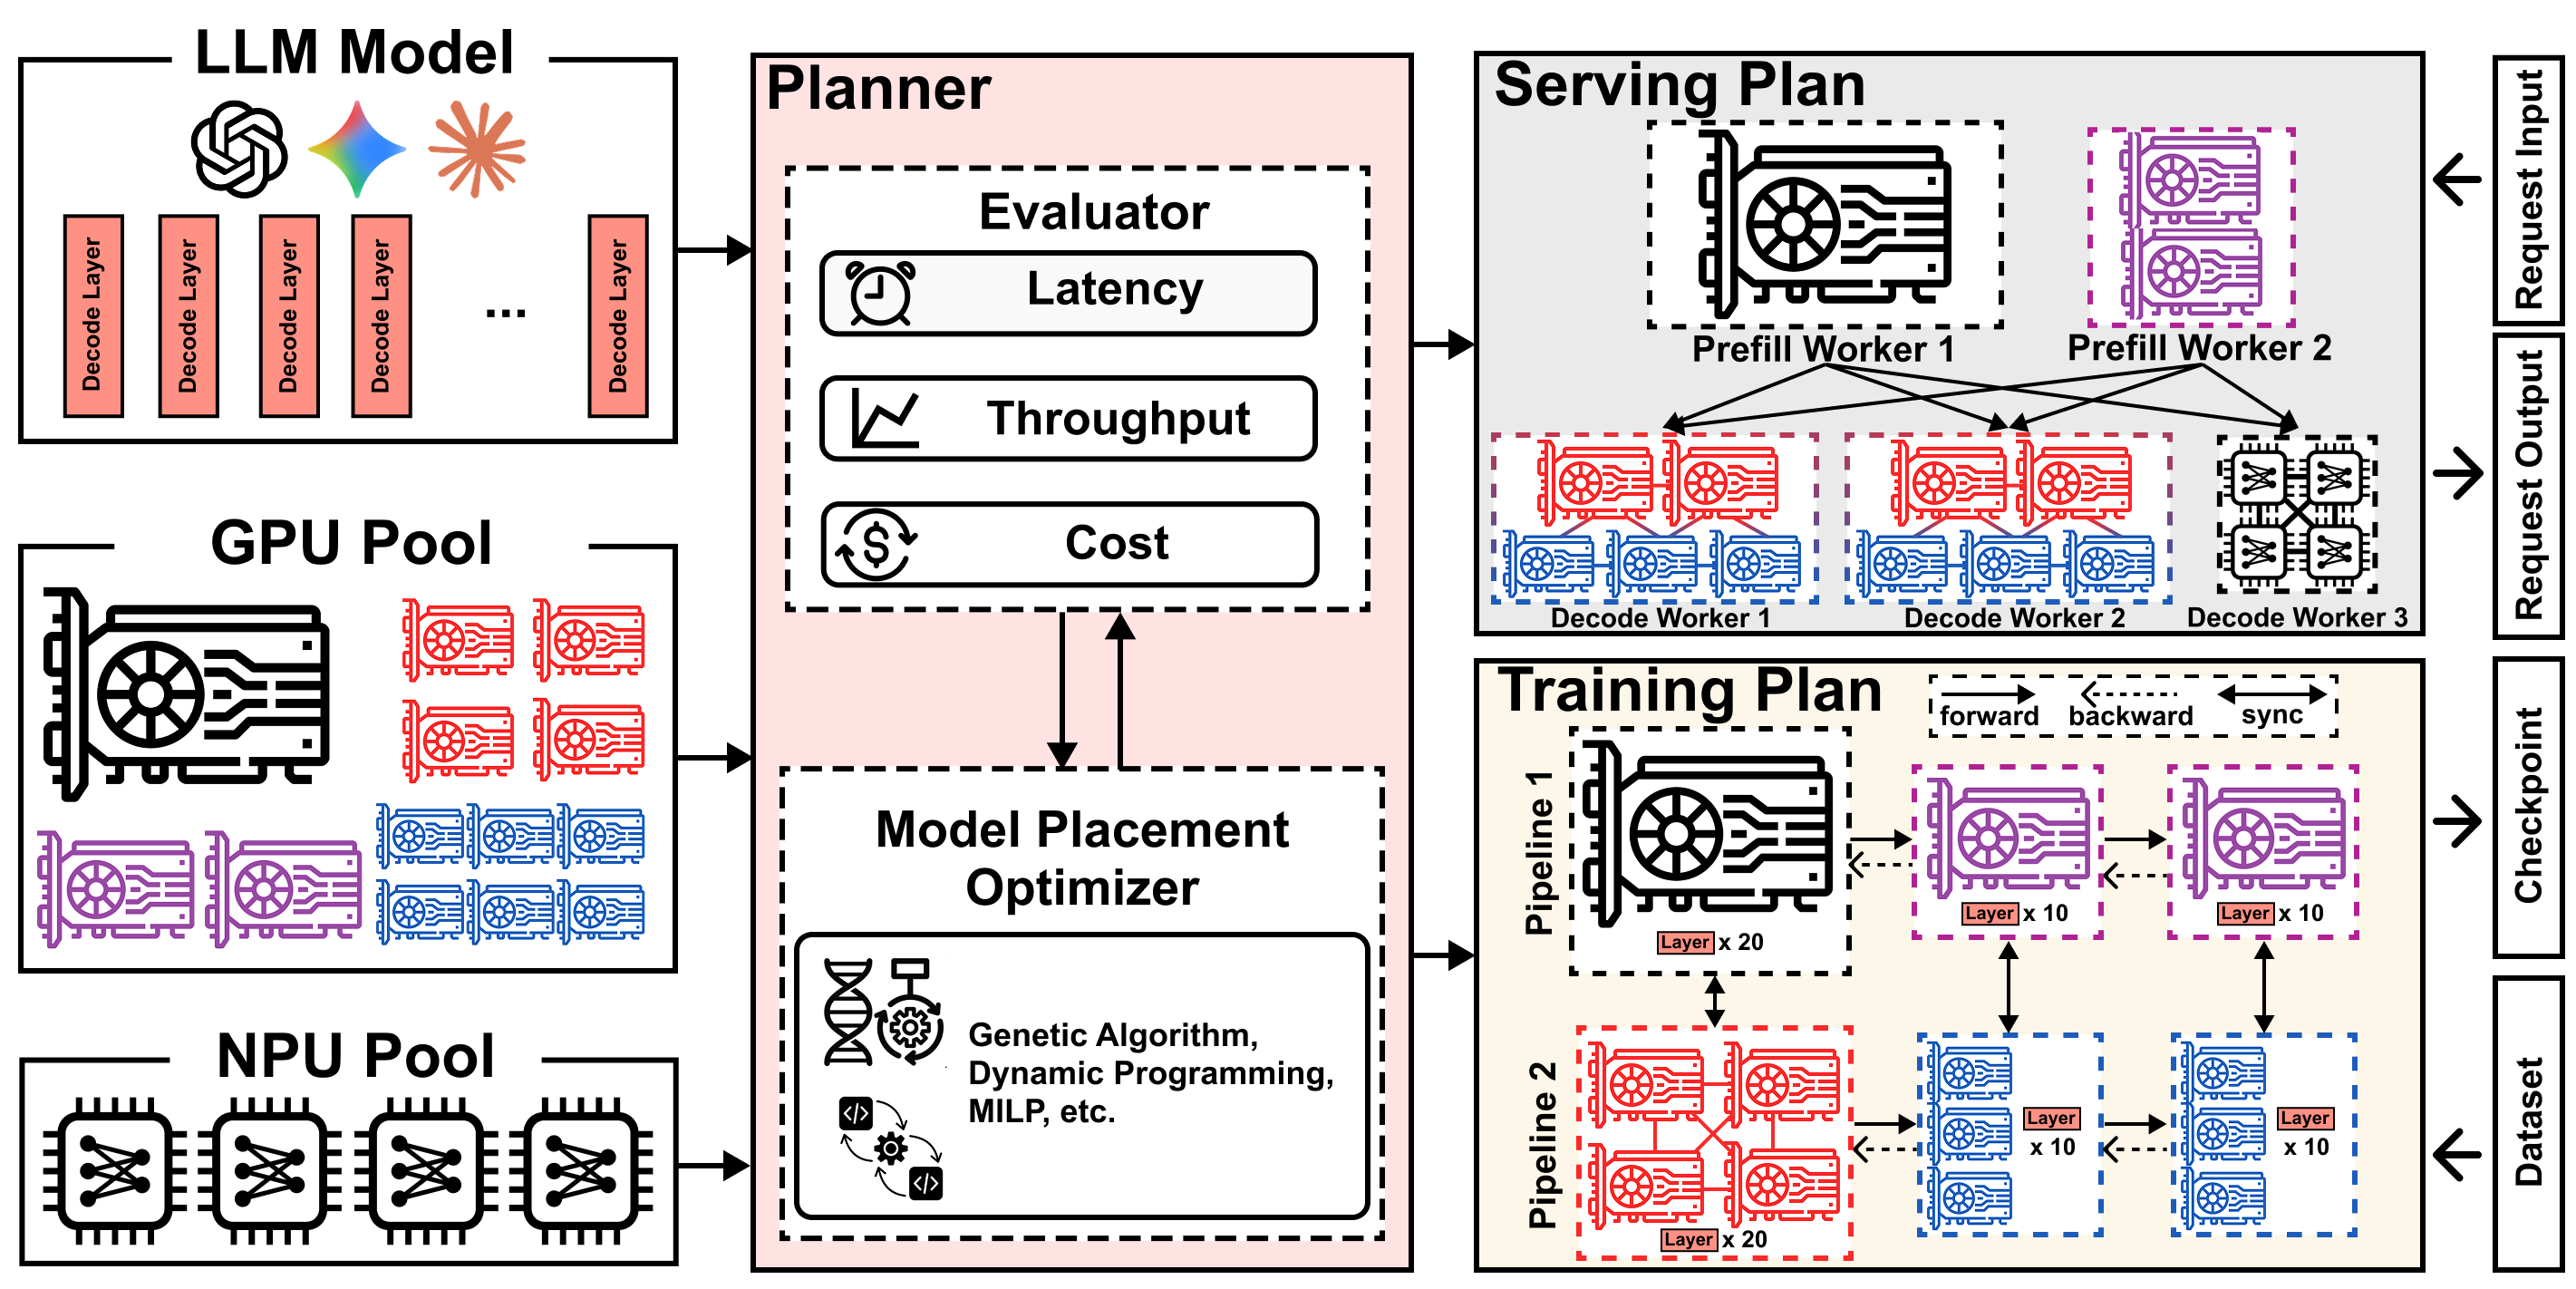
거대 언어 모델(Large Language Model, LLM)의 크기가 증가함에 따라 모델을 여러 가속기 장치에 분배하는 분산 학습 및 추론이 핵심 기술로 대두되고 있다. 가장 대표적인 가속기 장치는 GPU이지만, 높은 수요로 인해서 지속적인 부족 문제가 발생하고 있으며 새로운 세대가 빠르게 출시되고 있어 대량의 고성능 동종 GPU들을 확보하기가 어렵다. 이러한 환경에서 낭비되고 있는 이전 세대의 GPU 들을 활용하는 것은 더 큰 모델의 학습 및 추론을 가능하게 하고 시스템 처리량을 증가하게 할 수 있다. 더욱이 추론 특화 NPU(예: Furiosa AI RNGD, AWS Inferentia)와 같이 특정 워크로드에 최적화된 가속기들을 통합함으로써 더욱 효율적인 시스템을 구축할 수 있다.
그러나 이기종 가속기들은 성능과 특성이 서로 달라, 동종 가속기를 전제로 한 방식을 그대로 적용하면 심각한 병목 현상이 발생하므로, 이를 고려한 최적화 알고리즘이 필수적이다. 더욱이 널리 사용되고 있는 vLLM, SGLang 그리고 Megatron-LM과 같은 분산 학습/추론 프레임워크는 동종 GPU 환경만을 고려하기 때문에 이기종 환경에서 실제로 구동될 수 있는 시스템의 구현이 병행되어야 한다. AI인프라혁신연구센터에서는 이기종 가속기 환경에서 실제로 동작하는 시스템과 함께 리소스 활용율을 최대화할 수 있는 최적화 알고리즘 및 시스템에 대한 연구를 수행 중이다.
2. 클라우드-엣지 통합 차세대 AI 인프라 및 지능형 운영 (AIOps) 기술
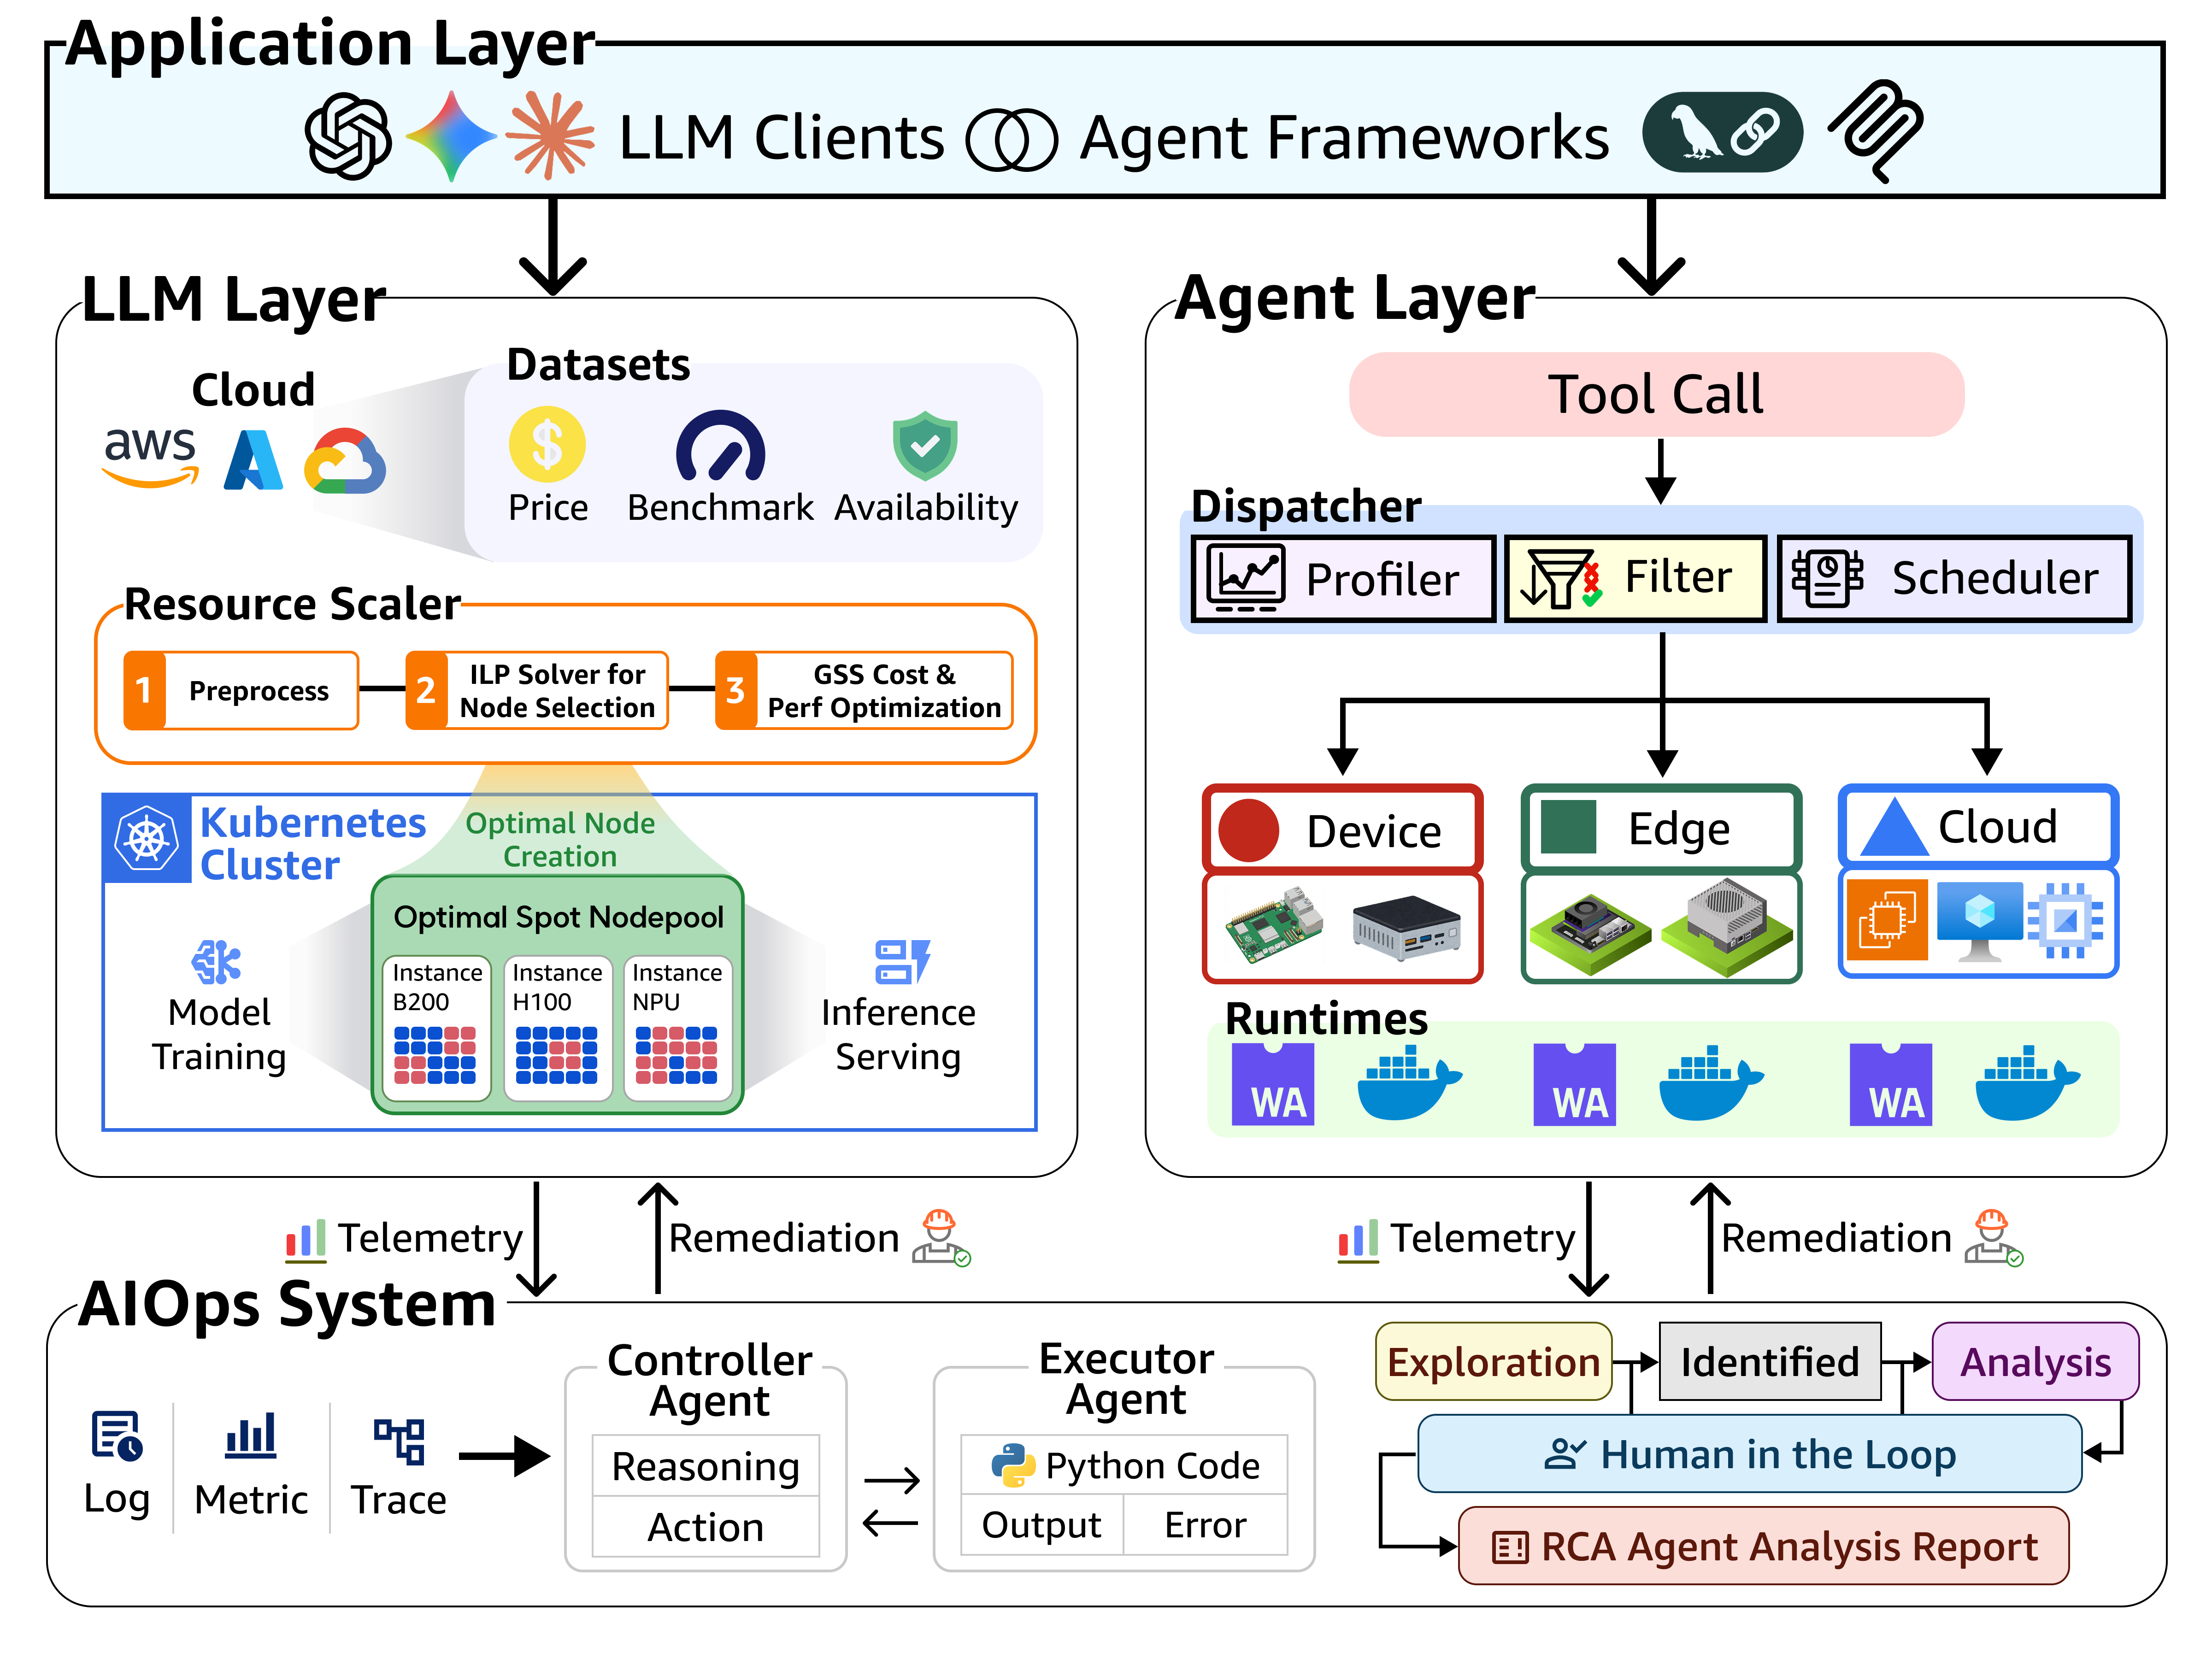
초거대 AI 모델의 등장으로 AI 워크로드는 퍼블릭 클라우드의 대규모 클러스터에서 수행되는 학습부터 엣지 디바이스에서의 실시간 추론 및 AI 에이전트 실행까지 클라우드-엣지 연속체 전반으로 확장되고 있다. 그러나 GPU 등 컴퓨팅 자원 비용의 급증, 디바이스·엣지 환경의 자원 제약과 x86, ARM, RISC-V와 같은 하드웨어 이질성, 그리고 분산 시스템의 복잡한 장애 양상은 차세대 AI 서비스의 비용 효율적이고 안정적인 운영을 어렵게 한다.
이러한 문제를 해결하기 위해서는 변동성이 큰 클라우드 자원을 지능적으로 구성하고, 클라우드-엣지 컴퓨팅 연속체 환경에서 에이전트 도구를 효율적으로 실행하며, 분산 인프라의 장애를 자동으로 진단하는 통합적인 시스템 소프트웨어 기술이 요구된다. AI인프라혁신연구센터에서는 클라우드 스팟 인스턴스의 가격·하드웨어 성능·가용성을 통합 최적화하여 AI 학습·추론 클러스터를 자동 구성하는 클라우드 기반 컨테이너 오케스트레이션 기술, WebAssembly와 같은 하드웨어 이질성 문제를 해결하는 경량 런타임으로 에이전트 도구를 디바이스-엣지-클라우드에 걸쳐 최적 배치·실행하는 런타임 기술, 그리고 LLM 에이전트가 메트릭·로그·트레이스를 종합 분석하여 시스템 장애의 근본 원인을 자동 진단하는 AIOps 기술을 연구하고 있다.
3. PIM (Processing-in-Memory) 기반 대용량 데이터 처리 기술
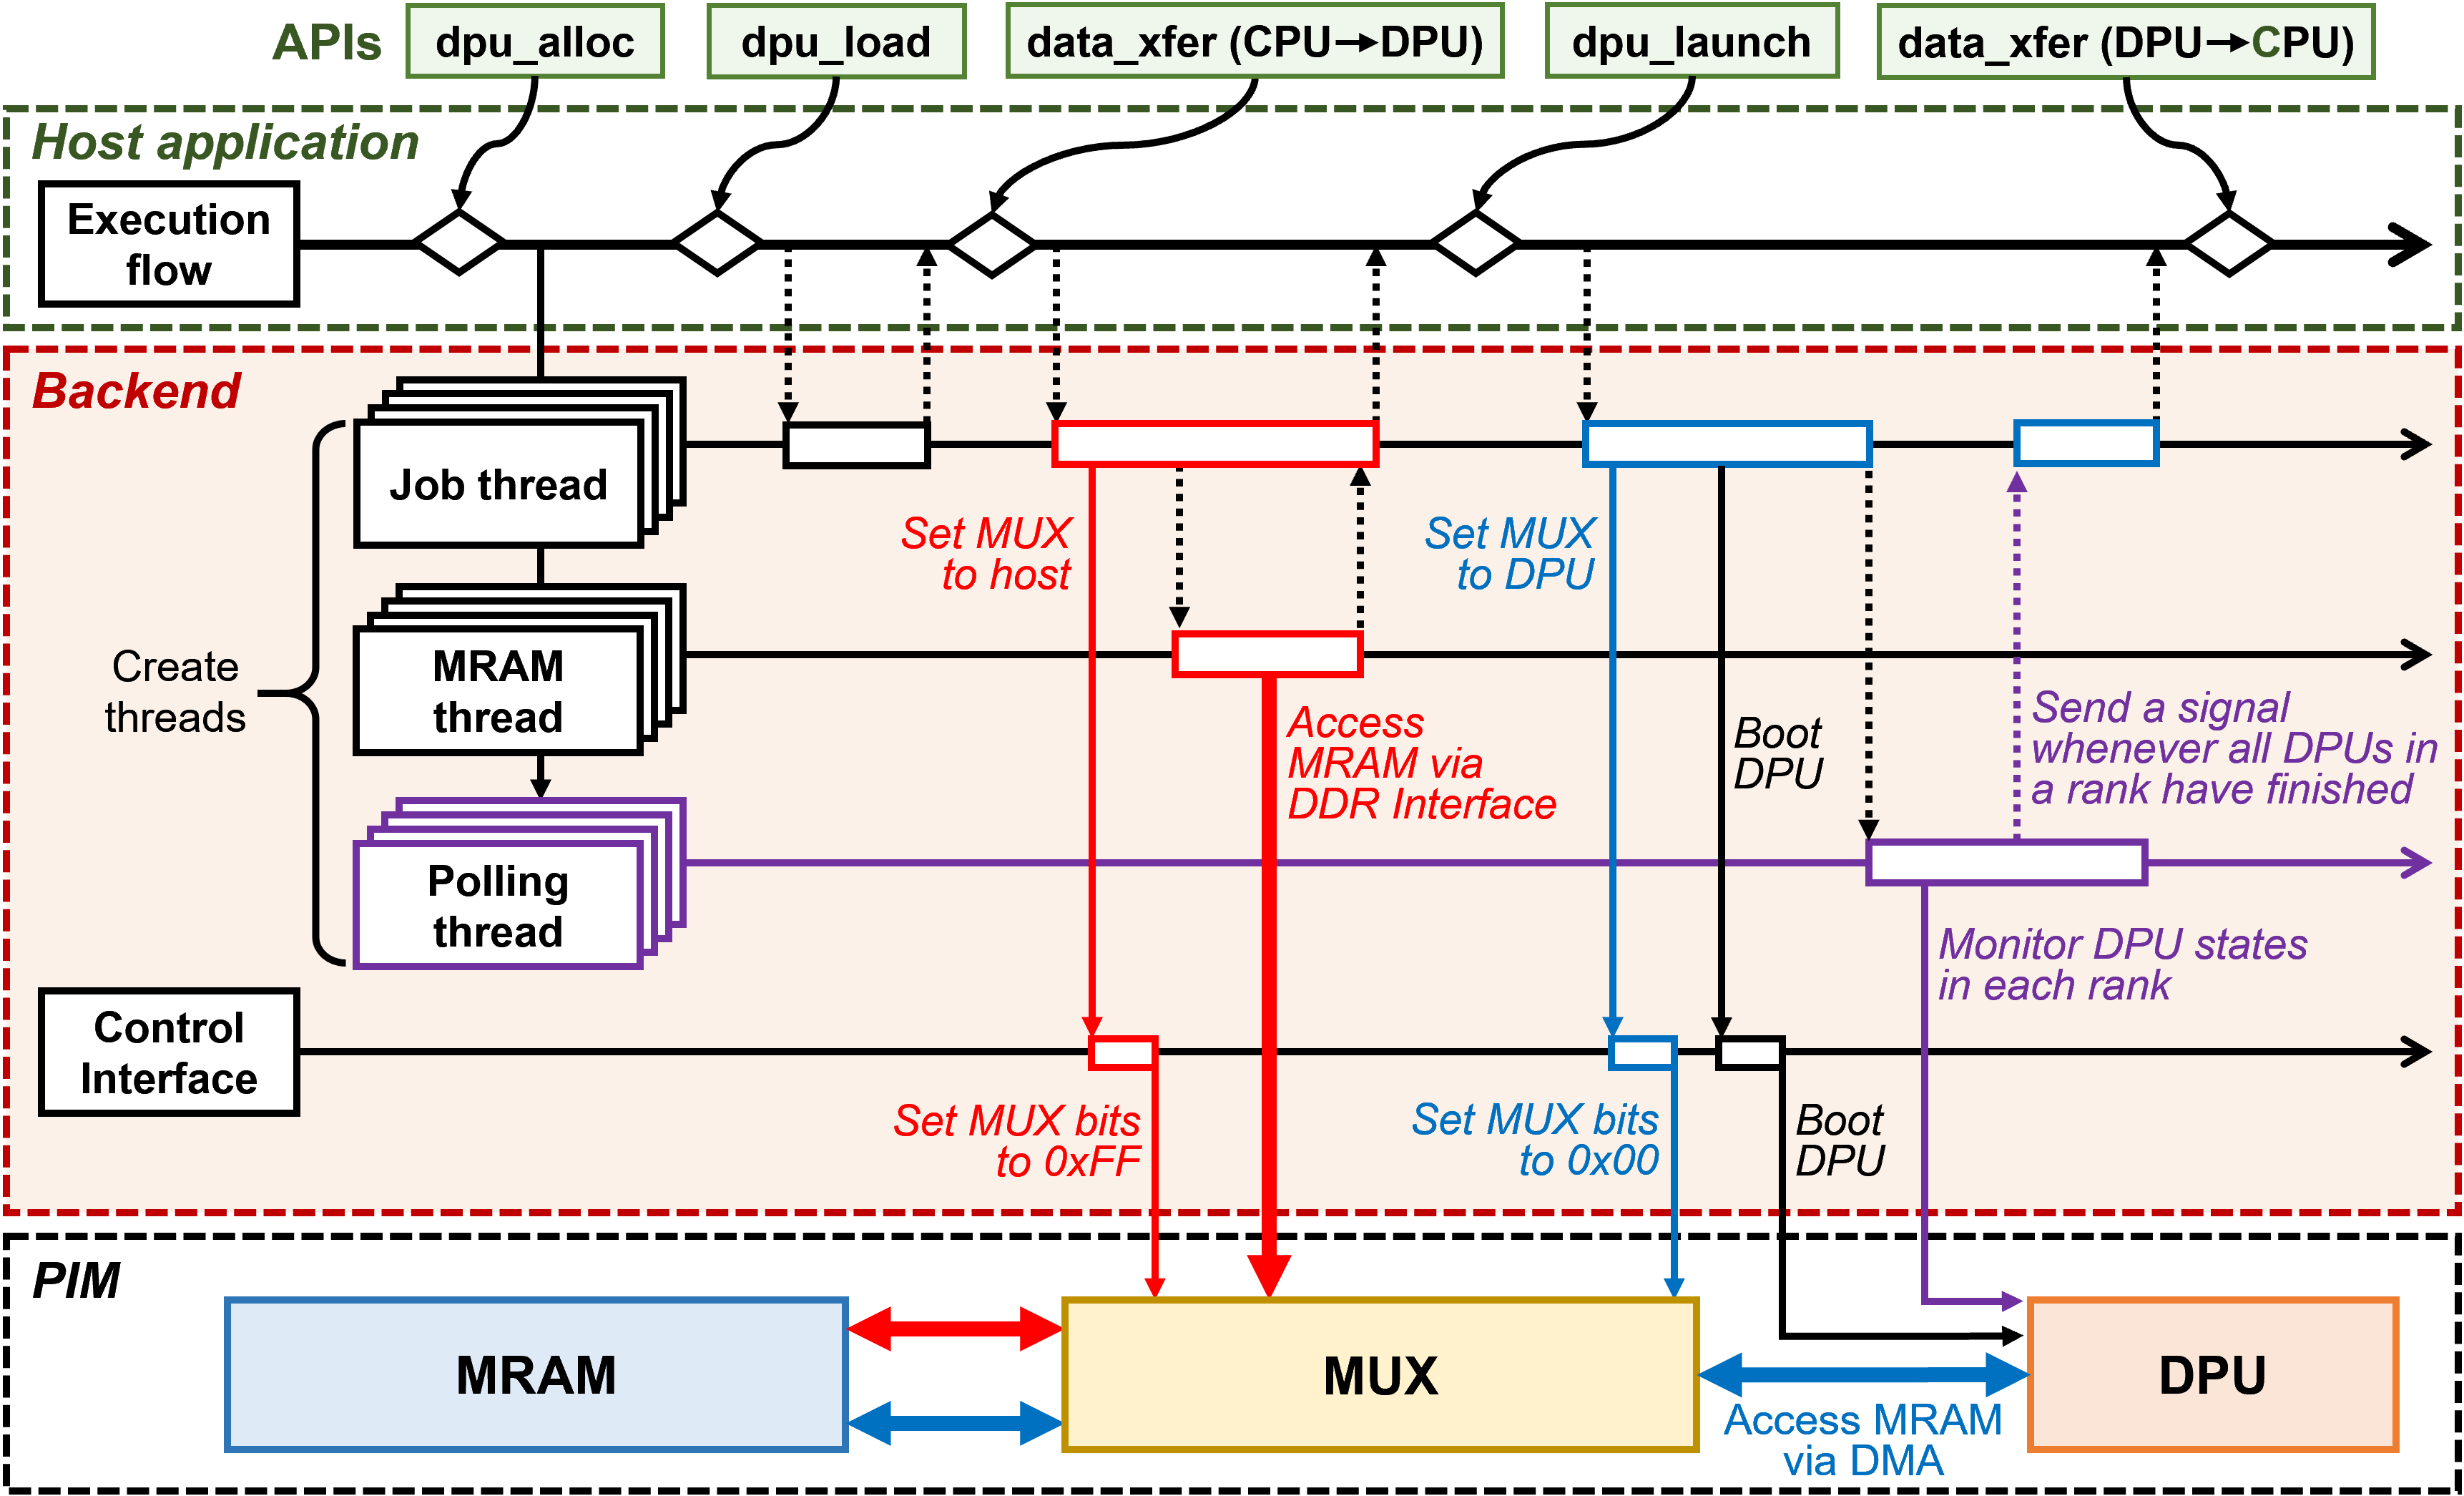
반도체 집적 기술의 발전에 따라 CPU 내 코어의 수가 점점 증가하고 있다. 코어 수의 증가는 계산 능력의 향상을 의미하므로 컴퓨터 시스템의 성능을 향상시킬 수 있으나, 각 코어에서 동시에 실행되는 많은 프로세스/쓰레드들로 인한 메모리 접근 빈도 역시 증가하게 된다. 특히 AI 응용프로그램과 같은 데이터 집중형 작업들로 인한 과도한 메모리 접근은 기존에는 관찰되지 않았던 메모리 병목 문제를 발생시킨다.
Processing-in-Memory는 이러한 문제를 해결하기 위해 최근 등장한 새로운 컴퓨팅 패러다임이다. 데이터를 저장하는 메모리(DRAM) 내에 다수의 프로세싱 유닛을 장착하여, CPU-Memory 간 데이터 전달 없이 메모리에서 필요한 연산을 직접 수행함으로써 메모리 병목 문제를 해결한다. AI인프라혁신연구센터에서는 PIM을 위한 시스템 소프트웨어 기술 및 PIM에 최적화된 데이터 처리 알고리즘을 연구하고 있다.
4. 아날로그 CIM (Compute-in-Memory) 특화 스케쥴링 기술
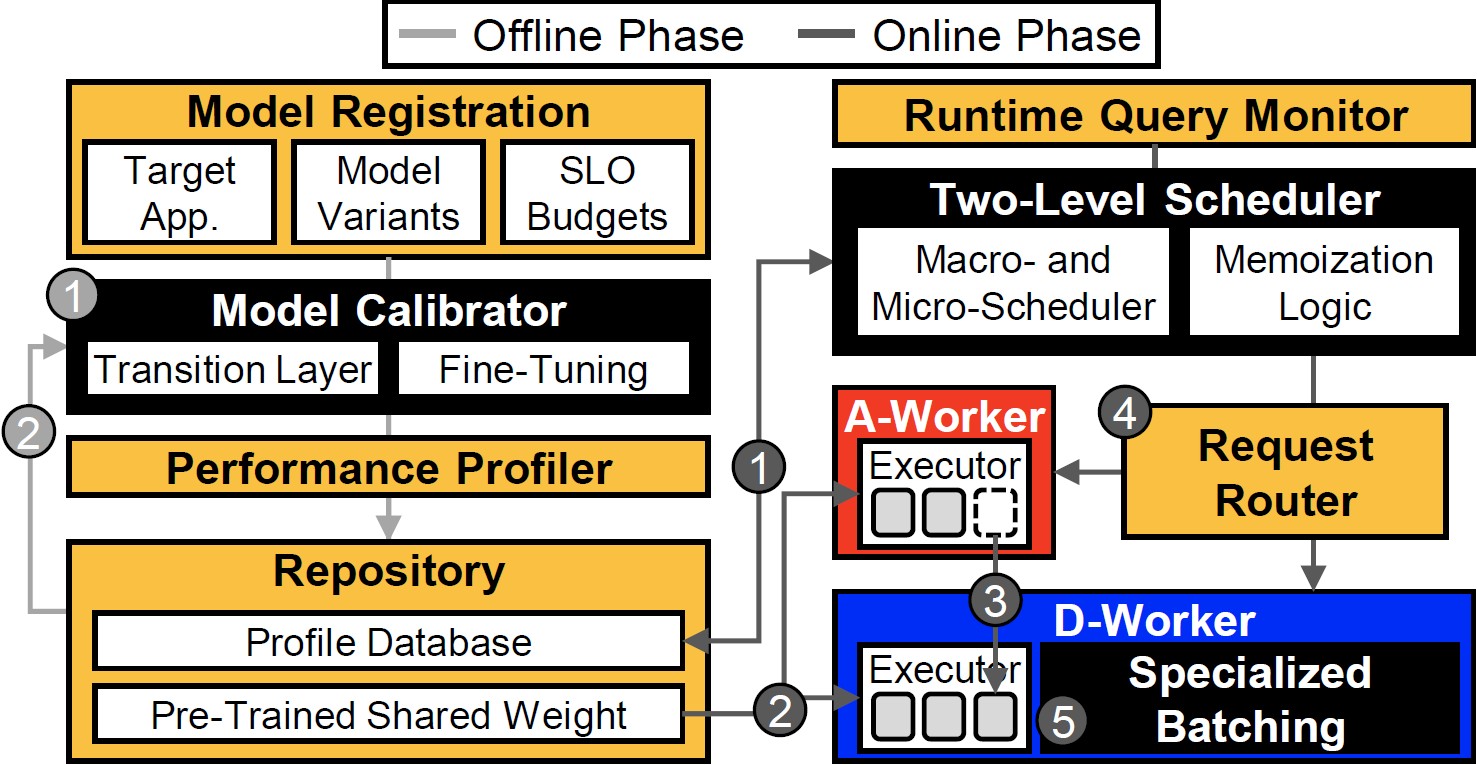
최근 대규모 AI 워크로드를 처리하는 과정에서 막대한 전력 소모와 메모리 병목 현상이 주요 문제로 대두되고 있다. 이를 극복하기 위해서는 기존 프로세서의 한계를 근본적으로 해결할 수 있는 새로운 형태의 프로세서가 필요하다.
아날로그 기반의 Compute-In-Memory는 메모리 셀 자체에서 아날로그 연산을 수행함으로써, 압도적인 병렬 처리 능력과 에너지 효율성을 제공하는 기술이다. 하지만 이러한 아날로그 기반 프로세서는 높은 연산 처리량과 에너지 효율을 얻는 대신, 구조상 연산 정확도가 떨어지는 한계를 가진다. 이에 AI인프라혁신연구센터에서는 아날로그 기반 CIM의 정확도를 상황에 따라 조절할 수 있는 매개변수로 활용하여, 이를 제어하는 시스템소프트웨어 기술과 최적화된 아키텍처 설계를 연구하고 있다.
5. 기밀 컴퓨팅 실행 환경 기반 데이터 보호 프레임워크
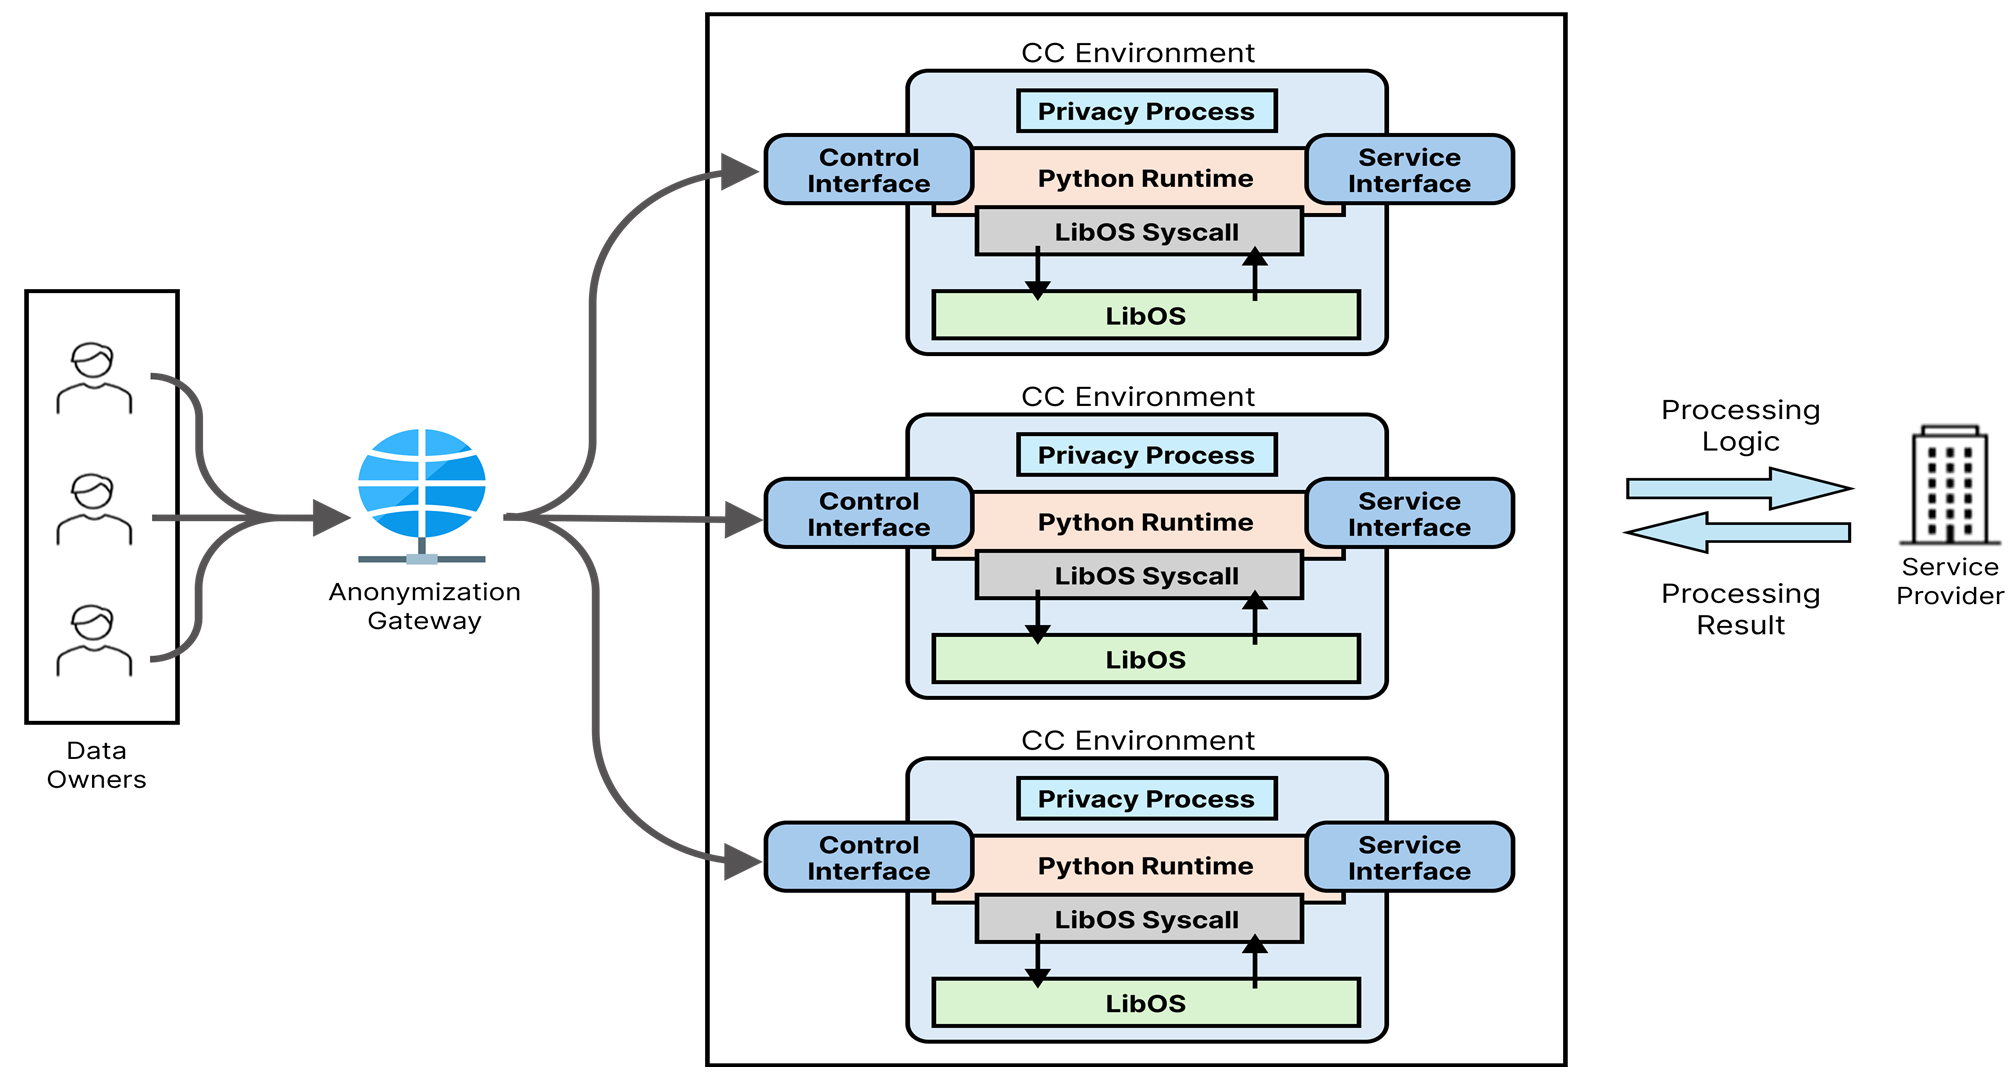
클라우드와 인공지능 기반 서비스의 확산으로 인해, 개인 디바이스·IoT·의료·금융 등 다양한 출처에서 생성되는 민감 데이터가 외부 서버 환경에서 처리되는 경우가 증가하고 있다. 이러한 환경에서는 데이터가 서비스 제공자나 인프라 관리자에게 노출될 수 있으며, 단순한 암호화만으로는 데이터 처리 과정에서 발생하는 접근 제어, 정책 검증, 실행 무결성 보장 문제를 충분히 해결하기 어렵다. 이를 위해 기밀 컴퓨팅 실행 환경(Confidential Computing Environment, CCE)을 활용하여, 데이터와 처리 로직을 격리된 실행 환경 내부에서 보호하는 구조가 요구된다.
AI인프라혁신연구센터에서는 이러한 요구를 만족시키는 데이터 보호 프레임워크 기술을 연구하고 있다. 각 정보 주체가 독립적인 CCE와 연결되며, 비식별화 게이트웨이(Anonymization Gateway)는 정보 주체와 해당 CCE 사이의 직접적인 연결 관계가 외부에 드러나지 않도록 중계하는 비식별화 지점으로 동작한다. 각 CCE 내부에서는 Control Interface를 통해 정보 주체의 데이터와 정책을 전달받고, Service Interface를 통해 서비스 제공자의 처리 로직과 연동된다. 이를 통해, 데이터 보호 프레임워크는 데이터 기밀성, 실행 무결성, 정책 기반 접근 제어를 제공하는 동시에, 정보 주체와 실행 환경 사이의 연결성을 비식별화하여 사용자 단위의 프라이버시를 강화할 수 있다.